少量动作监督也有明显收益
只改变参与动作损失的标定轨迹覆盖率,重建与量化目标使用相同数据。图中衡量的是 DROID 留出集上的线性探针 R²。
- 0% → 30% 覆盖
- 0.23 → 0.72
- 总 R²
- 1% 覆盖
- ≈69%
- 达到平台表现的比例
- 约 20% 覆盖
- 趋于平稳
- 继续增加监督,提升趋缓
从生成视频学习,让机器人适应新环境,无需目标环境专家示教
论文报告的平均成功率 · LIBERO 目标环境 · 无目标环境专家示教
生成视频提供目标环境的视觉经验,隐动作模型将帧间变化编码为动作 token。 策略结合这些 token 与源环境的动作监督,学习目标环境中的操作方式。
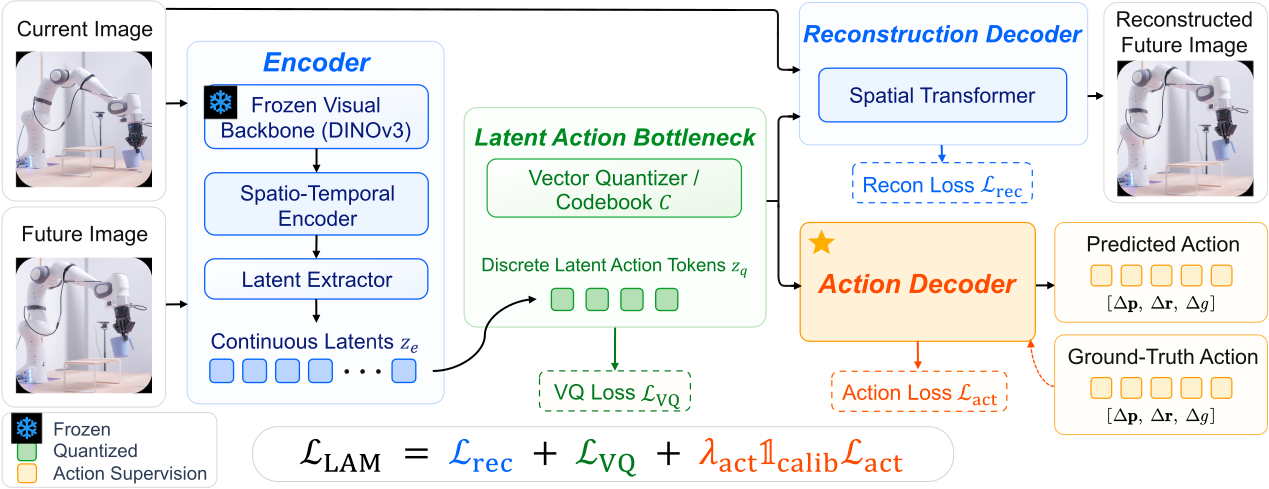
将预训练的视觉-语言-动作(VLA)策略部署到新环境,通常需要在每个目标环境重新采集专家示教,成本高、难以扩展。 我们提出 FreeAct,一个无需示教的机器人适应框架,把生成视频转化为有物理依据的监督。 难点在于:生成的操作视频看起来逼真,却常带有机械臂形态伪影和运动学不一致,直接用逆动力学模型标注并不可靠。 FreeAct 在大规模多实验室机器人视频上学习离散隐动作空间,并使其与相机坐标系下的末端 SE(3) 运动和夹爪状态变化对齐。 由此得到的隐动作 tokenizer 抓住与任务相关的运动,减少对特定机械臂外观伪影的依赖,从而能为生成的目标环境视频打上可靠的隐动作 token。 这些 token 先用于 VLA 预训练,再与源域动作监督一起,把策略适应到新环境。
实验中,仅用生成视频,FreeAct 在目标域偏移下把成功率从 2% 提升到 57%;再由多模态大模型(MLLM)从策略自己的执行中挑选样本进行自进化,进一步提升到 74%,全程不需要专家示教。 进一步分析表明,学到的隐动作空间具有运动学结构且可迁移,说明生成视频可以成为机器人操作的可扩展监督来源。
冻结的 DINOv3 编码相隔 1 秒的帧对,量化成 4 个离散 token(码本 64)。额外的动作解码器在有相机外参的数据上回归相机坐标系的末端动作,让码本对应可执行的运动。
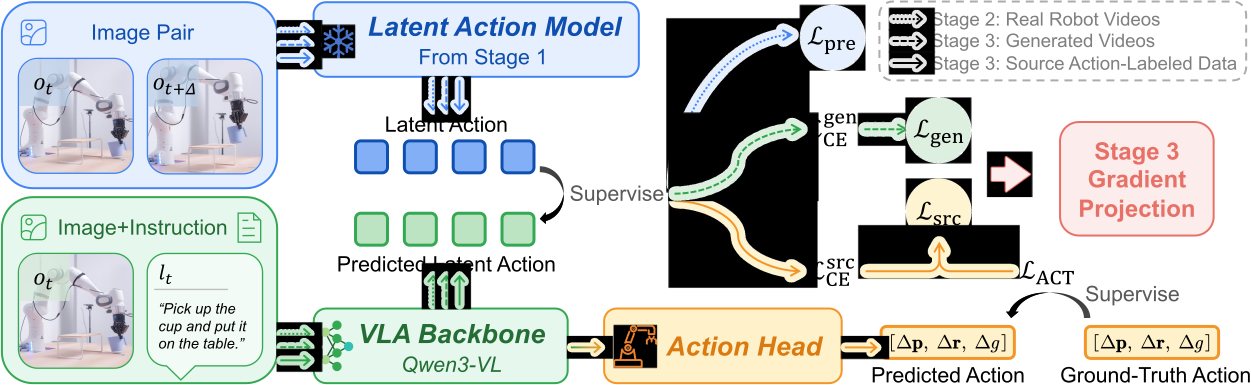
Qwen3-VL-4B 从当前画面和指令预测隐动作 token,在 DROID 与 LIBERO 的真实机器人视频上训练,不需要动作标签。
源域示教同时监督 token 和连续动作头;生成的目标环境视频只监督 token。两路梯度冲突时,用梯度投影去掉冲突分量。
多模态大模型从策略自己在目标环境的执行中挑选成功的几段,再训练一轮,仍不需要专家示教。
探索生成视频中的运动读出、机械臂外观变化,以及策略适应与自进化的结果。
策略只在源环境(LIBERO-spatial,抓黑碗的边沿)有示教。目标环境同时改变了外观和技能:光照、桌面纹理、机械臂配色都变了, 要抓的物体换成牛奶盒,需要用两指包住整个盒身,而不是夹住碗沿。 Tasks A–E 对应论文中的五个目标任务;下拉框还包括 Task B 的相机变化(方位角 +5°)和 Task C 的物体变化(番茄酱瓶),其余设置与对应任务相同。
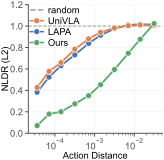
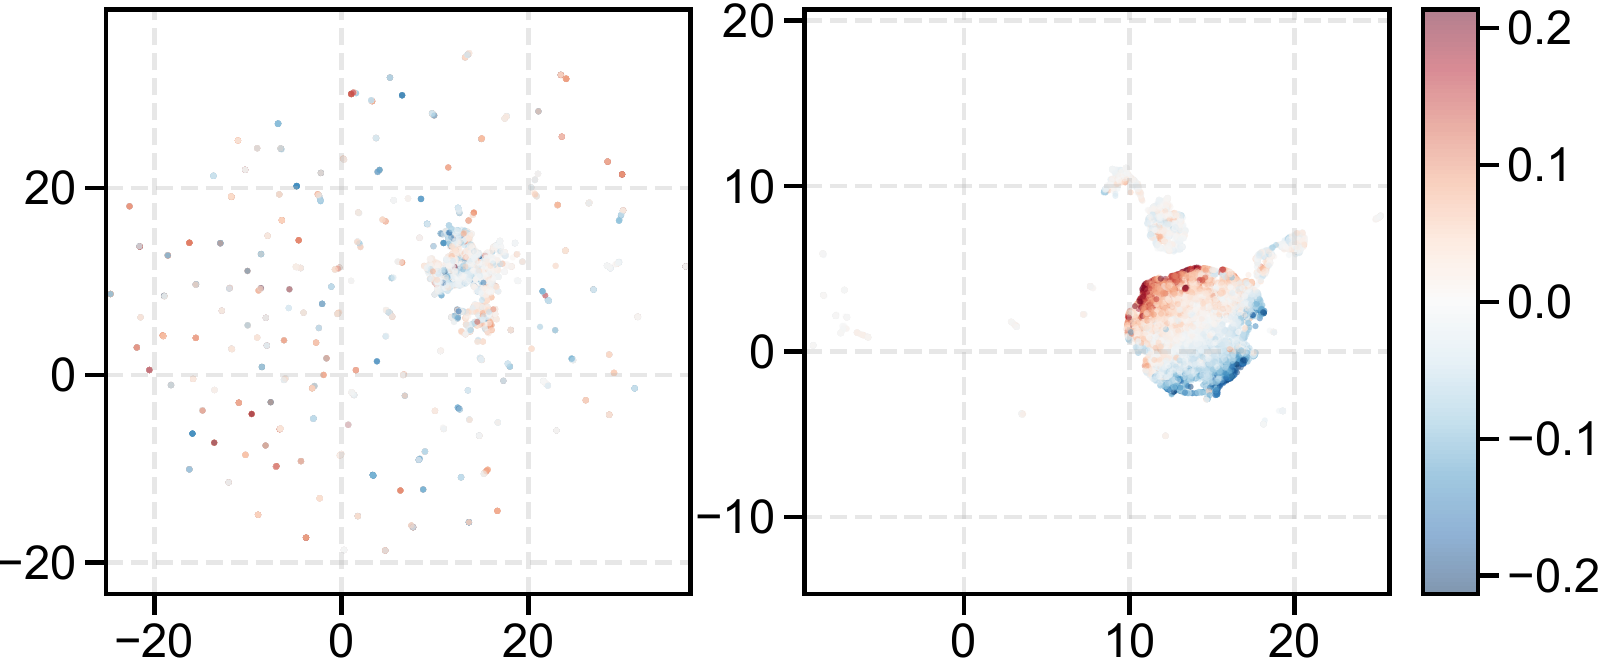
从监督覆盖率、动作读出和空间结构,考察 FreeAct 学到的隐动作表示。
只改变参与动作损失的标定轨迹覆盖率,重建与量化目标使用相同数据。图中衡量的是 DROID 留出集上的线性探针 R²。
线性探针衡量动作信息是否可读出;NLDR 与 UMAP 进一步检查隐空间的几何结构。
冻结隐动作表示,用岭回归预测 7 维动作。R² 越高越好;归一化 MSE 越低越好。

按当前任务浏览,或查看一致性较低的片段。缩略图上的 r 取左右、上下两个方向中较低的相关系数;选择缩略图即可载入播放器。
在真实机器人数据集 DROID 的 个留出帧对上,只用一个 token 预测各运动分量的 R² (0 = 毫无信息,1 = 完全决定)。相机坐标系:x 向右,y 向下,z 指向场景深处。
少量自主执行即可进一步适应。论文从每任务 50 段候选执行中,选取最多 5 段用于一轮自进化;Task E 从 8% 提升至 52%。
三列使用同一时间轴;较短视频停在末帧,最长视频结束后整组重播。操作任一播放器可控制整组。
@inproceedings{mo2026freeact,
title = {FreeAct: Demonstration-Free Robot Adaptation via Action-Grounded Generated Videos},
author = {Mo, Zhe-Han and Li, Jia-Ning and Song, Jiaxi and Guo, Meng-Hao and Hu, Shi-Min},
booktitle = {Advances in Neural Information Processing Systems (NeurIPS)},
year = {2026}
}